
批量 PDF/OCR 归档系统
面向档案归集场景,批量完成 PDF/OCR 识别、拆分和归档。
批量 PDF/OCR 归档系统
面向档案归集场景,批量完成 PDF/OCR 识别、拆分和归档。
功能需求文档
建议按「背景 / 问题 / 实施 / 成果」阅读交付叙事,再展开功能范围、流程与验收细节。
- 01背景业务场景与交付前提
- 02问题需要解决的关键约束
- 03实施方案落地与工程路径
- 04成果可验收的业务结果
问题业务问题
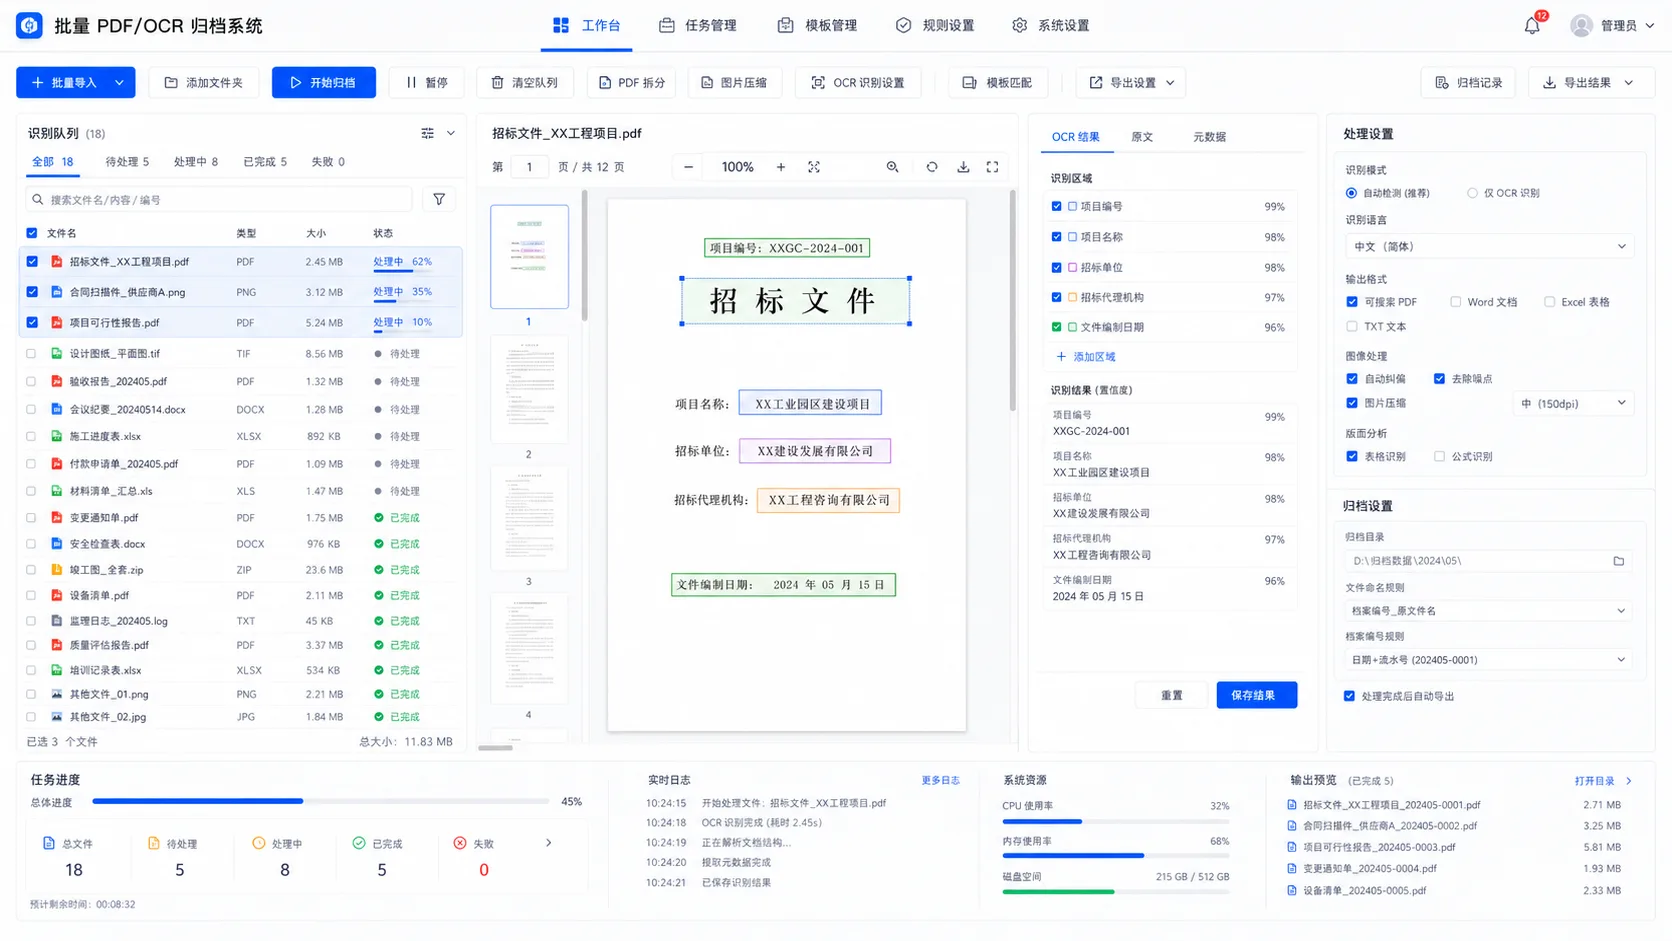
批量 PDF/OCR 归档系统属于图像/转换场景,面向企业档案、招投标资料和扫描文件的批量识别归档系统,截图重点是识别队列、PDF 页面预览、OCR 区域框选、处理参数、归档目录、实时记录、系统资源和输出预览。
适用用户
档案归集、审计资料、项目交付和历史文件数字化团队。
实施操作流程
- 批量导入 PDF、图片、Word、Excel、ZIP 等资料
- 系统进入识别队列并按状态展示处理进度
- 用户在预览区核对页面并可调整识别区域
- 用户选择 OCR、压缩、拆分、模板匹配和导出设置
- 系统生成归档文件、记录、资源指标和输出预览
输入与输出
该系统需要重点输出:
- 可搜索 PDF
- OCR 文本或 Word 文档
- 按规则命名的归档文件
- 实时记录
- 系统资源使用率
- 输出文件列表
功能与界面要求
截图可见信息组织
顶部导航和一级模块包括:
- 工作台
- 任务管理
- 模板管理
- 规则设置
- 系统设置
左侧区域需求:左侧识别队列展示批量导入后的文件,包含全部、待处理、处理中、已完成、失败等状态标签,并显示文件名、类型、大小、状态和处理进度。底部任务进度统计展示总文件、待处理、处理中、已完成、失败数量。
主工作区需求:中间区域展示当前 PDF 原文预览,支持页码、缩放、下载、全屏、页面缩略图和识别区域框选。用户可以在页面上看到项目编号、项目名称、招标单位、代理机构、文件编制日期等区域被单独标注。
右侧与辅助区需求:右侧配置区包含 OCR 结果、原文、元数据、处理设置和归档设置。处理设置包含自动检测、语言选择、可搜索 PDF、Word、Excel、TXT 输出、自动纠偏、去除噪点、图片压缩、表格识别和公式识别。归档设置支持归档目录、文件命名规则、档案编号规则和处理完成后自动导出。
核心功能需求
- 配置复用:支持保存常用业务模板与规则,配置项使用清晰的业务名称。
接口数据链
本案例的接口数据链以“批量 PDF/OCR 归档系统”的操作流程为顺序:上一步返回的业务标识、规范化结果或状态进入下一步,页面同时保留来源与处理状态。接口信息按当前公开接口契约展示,文章只维护业务步骤之间的流转关系。
异常边界
密码保护、破损文件、空白扫描页和低识别率页面应单独进入复核队列。
成果验收标准
- 核对 批量 PDF/OCR 归档系统 的输入对象、筛选条件、结果字段和更新时间是否与当前业务场景一致。
- 按操作流程逐步核对接口文档入口、请求条件、返回结果与上下游业务关系。
- 成功、处理中、待复核、失败和数据不足等状态均需使用业务语言明确展示。
- 桌面端与移动端均可阅读正文、查看案例图片和使用相关接口入口,页面无横向溢出。
- 案例标题、正文、图片与咨询入口完整可用,展示内容与当前业务场景一致。
下一步
验收后的档案可以进入全文检索、审计取证或长期存储。如需评估自己的数据、页面和业务流程,可以从当前案例的接口蓝图核对输入输出,再联系 GuGuData Engineering 讨论实现范围与验收方式。